Maxwell で MySQL の バイナリログ を JSON に変換する
バイナリログからデータを吸い出したいケース
MySQL の障害復旧というと、まずバックアップからの復元(PITR)が思い付きます。 しかし実際の運用では、データベース全体を過去の時点へ戻したいとは限りません。
例えば、アプリケーションのバグなどで、レコードごとに異なるタイミングで誤った更新が行われることがあります。このような場合、レコードごとに異なる時点のデータが必要になります。
このような場合に役立つのがバイナリログ( binlog )です。 バイナリログ には INSERT、UPDATE、DELETE といった変更履歴が記録されているため、
- どのレコードが
- いつ
- どのように変更されたか
を後から追跡できます。
バイナリログの形式
binlog はバイナリ形式で保存されているため、そのままでは内容を読むことができません。
内容を確認するには、MySQL に付属している mysqlbinlog コマンドを利用します。binlog を見やすく表示するには、--base64-output=DECODE-ROWS と --verbose オプションを利用します。
$ mysqlbinlog --base64-output=DECODE-ROWS --verbose mysql-bin.000001
例えば次のような UPDATE が実行されたとします。
UPDATE t1
SET v = 'new value'
WHERE pk = 1;
すると binlog には次のような内容が記録されます*1。
### UPDATE `sample`.`t1`
### WHERE
###   @1=1
###   @2='old value'
### SET
###   @1=1
###   @2='new value'
更新前の値(WHERE)と更新後の値(SET)が確認できるため、レコードがどのように変更されたかを追跡できます。
少量の調査であれば mysqlbinlog だけでも十分ですが、変更履歴を機械的に処理したい場合には扱いづらさを感じます。
そこで今回は Maxwell を利用して、binlog を JSON 形式へ変換してみます。
Maxwell を試す
Maxwell は Zendesk が開発している MySQL 向けの CDC(Change Data Capture)ツールです。MySQL のレプリカとして接続し、binlog を読み取りながら変更内容を JSON 形式で出力することができます。
bin/maxwell \
  --host=localhost \
  --user=maxwell \
  --password=xxxx \
  --producer=stdout
起動すると Maxwell は MySQL に接続し、binlog の読み取りを開始します。
例えば次の UPDATE を実行します。
UPDATE t1
SET v = 'new value'
WHERE pk = 1;
すると Maxwell は次のような JSON を出力します。
{
  "database": "sample",
  "table": "t1",
  "type": "update",
  "ts": 1749600000,
  "data": {
    "pk": 1,
    "v": "new value"
  },
  "old": {
    "v": "old value"
  }
}
mysqlbinlog の出力と比べると、かなり扱いやすくなっています。
Maxwell のオプション
Maxwell にはフィルタ機能もあります。例えば次のようにオプションを設定すると、sample.t1 テーブルの変更だけを取得できます。
--filter=include:sample.t1
Maxwell はデフォルトでは起動時点の最新の binlog 位置から処理を開始します。
一方で、過去の binlog を解析したい場合は --init_position を指定できます。
bin/maxwell \
  --host=localhost \
  --user=maxwell \
  --password=xxxx \
  --producer=stdout \
  --init_position=mysql-bin.000123:456789
これは今回のような調査用途では非常に便利です。 問題が発生した時刻以降の binlog を指定することで、必要な範囲だけを JSON として取得できます。
Maxwell のメタデータ
Maxwell は binlog を読み取る際に、内部的なメタデータを MySQL 上に保存します。 初回起動時には maxwell スキーマが作成され、その中にいくつかの管理テーブルが作成されます。
特に重要なのが次の2つです。
| テーブル | 用途 |
|---|---|
| positions | 現在の binlog の読み取り位置 |
| schemas | Maxwell が認識しているスキーマ情報 |
mysql> show tables from maxwell;
+-------------------+
| Tables_in_maxwell |
+-------------------+
| bootstrap         |
| columns           |
| databases         |
| heartbeats        |
| positions         |
| schemas           |
| tables            |
+-------------------+
7 rows in set (0.00 sec)
positions テーブルには、Maxwell が最後に処理した binlog のファイル名やポジションが保存されます。 そのため、一度停止した後に再起動しても、前回の続きから処理を再開できます。
mysql> select * from positions \G
*************************** 1. row ***************************
          server_id: 1
        binlog_file: mysql-bin.000003
    binlog_position: 1059
           gtid_set: NULL
          client_id: maxwell
       heartbeat_at: NULL
last_heartbeat_read: 0
1 row in set (0.00 sec)
一方、schemas テーブルにはテーブル定義の履歴が保存されます。
mysql> select * from `schemas` \G
*************************** 1. row ***************************
                 id: 1
        binlog_file: mysql-bin.000003
    binlog_position: 4
last_heartbeat_read: 0
           gtid_set: NULL
     base_schema_id: NULL
             deltas: NULL
          server_id: 1
       position_sha: 44e4a4c80596f267066c22b1110298c5d1a4e06c
            charset: utf8mb4
            version: 4
            deleted: 0
*************************** 2. row ***************************
                 id: 2
        binlog_file: mysql-bin.000004
    binlog_position: 235
last_heartbeat_read: 0
           gtid_set: NULL
     base_schema_id: 1
             deltas: [{"type":"table-alter","database":"d","table":"t1","old":{"database":"d","charset":"utf8mb4","table":"t1","columns":[{"type":"int","name":"pk","signed":true},{"type":"varchar","name":"v","charset":"utf8mb4"},{"type":"datetime","name":"updated","column-length":0}],"primary-key":["pk"]},"def":{"database":"d","charset":"utf8mb4","table":"t1_old","columns":[{"type":"int","name":"pk","signed":true},{"type":"varchar","name":"v","charset":"utf8mb4"},{"type":"datetime","name":"updated","column-length":0}],"primary-key":["pk"]}}]
          server_id: 1
       position_sha: b1aa767914be6aea39d331882bee9aba9d39c90f
            charset: utf8mb4
            version: 4
            deleted: 0
Maxwell のスキーマトラッキング
Maxwell 内部でテーブル定義を管理しており、CREATE TABLE, ALTER TABLE といった DDL を追跡しながら動作しています。
mysqlbinlog コマンド の出力では、
### UPDATE `sample`.`t1`
### WHERE
###   @1=1
###   @2='old value'
### SET
###   @1=1
###   @2='new value'
のように、カラム名ではなく @1 や @2 といった形式で値が出力されます。
一方で、Maxwell はテーブル定義を保持することで、
{
  "pk": 1,
  "v": "new value"
}
のように実際のカラム名を含めた、わかりやすいJSON を生成しています。
スキーマトラッキングによる制約
--init_position で開始時点を指定できると書きましたが、実際このオプションを使用すると、以下のようなエラーが発生しました。
2026-06-12 07:11:17 ERROR AbstractSchemaStore - Error on bin log position Position[BinlogPosition[mysql-bin.000004:974], lastHeartbeat=0]
com.zendesk.maxwell.schema.ddl.InvalidSchemaError: Unexpectedly asked to create existing table t1_histories
Maxwell は起動時にデータベースのスキーマ(テーブル定義)を取得し、その情報を利用して binlog を解釈しています。
例えば、Maxwell が接続した時点で t1_histories テーブルが存在しているとします。
t1_histories テーブルがすでに存在している状態で、過去の binlog に含まれるCREAT TABLE t1_histories 〜 を評価することでこのようなエラーになります。
Maxwell は、 「現在のスキーマの状態」と「binlog を読み始める時点のスキーマの状態」が一致していることを前提としているようでした。
そのため、過去の任意の時点から binlog を解析したい場合は、binlog だけでなくデータベースのスキーマもその時点の状態に合わせる必要があります。 今回の用途では、バックアップからデータベースを復元し、PITR によって解析対象の時点まで戻した環境に対して Maxwell を実行する必要があります。
*1:binlog_format=ROW, binlog_row_image=FULL を前提としています
TiDB パーティションとグローバルインデックスによる性能の変化を確認する
このエントリーは TiDB Advent Calendar 2025 の 17日目の記事です。 昨日は @bohnen さんの、TiDBのMVCCを理解する(1) #TiDB - Qiita でした。
先日、MySQL でパーティションの効果について考察しました。
タイミング良く? 2025-11-27 にリリースされた、TiDB v8.5.4 で グローバルインデックスの拡張が入ってました。今回は、 TiDB でパーティションの効果(パフォーマンス)を検証したいと思います。
グローバルインデックスとは
グローバルインデックスはテーブルをパーティション化した際に、そのパーティションを横断して検索できる単一のインデックスです*1。「パーティション化されてないインデックス」と捉えれば良いでしょう。
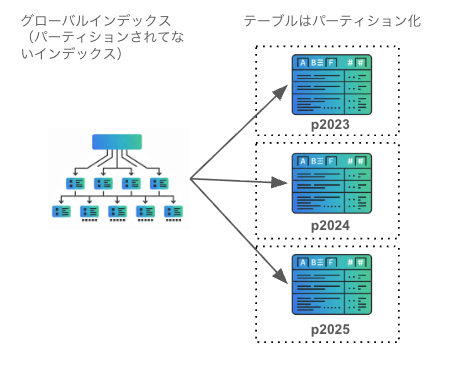
本エントリーでは、各パーティション個別に作成されるインデックスを「ローカルインデックス」と、記載します。
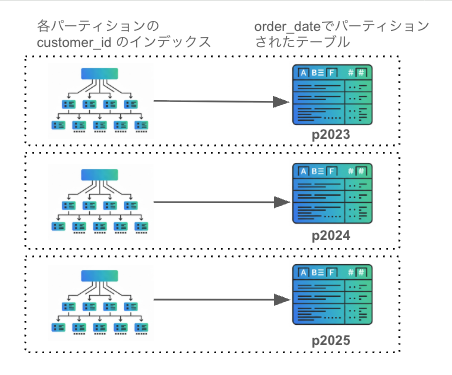
TiDB では グローバルインデックスが作成できる
Support creating global indexes on non-unique columns of partitioned tables #58650 @Defined2014 @mjonss
Starting from v8.3.0, you can create global indexes on unique columns of partitioned tables in TiDB to improve query performance. (TiDB 8.5.4 Release Notes | TiDB Docs)
MySQLではローカルインデックスしか作成できませんが、TiDB ではグローバルインデックスを選択できます。 v8.3.0 ではユニークインデックスに限られていたグローバルインデックスが v8.5.4 でその制約がなくなりました。
グローバルインデックスを作成するには、TiDB 独自の GLOBAL 句を追加します。
mysql> CREATE TABLE `t` (
    ->   `id` bigint NOT NULL AUTO_INCREMENT,
    ->   `customer_id` bigint NOT NULL,
    ->   `order_date` date NOT NULL,
    ->   PRIMARY KEY (`id`,`order_date`),
    ->   KEY `idx_customer_id` (`customer_id`) GLOBAL,
    ->   KEY `idx_order_date` (`order_date`)
    -> ) ENGINE=InnoDB
    -> PARTITION BY RANGE (year(`order_date`))
    -> (PARTITION p2008 VALUES LESS THAN (2008),
    ->  PARTITION p2016 VALUES LESS THAN (2016)
    ->  );
Query OK, 0 rows affected (0.06 sec)
もしくは、こう。
mysql> CREATE  INDEX idx_customer_id ON t(customer_id) GLOBAL;
Query OK, 0 rows affected (0.27 sec)
グローバルインデックスかどうかは INFORMATION_SCHEMA.TIDB_INDEXES の IS_GLOBAL で確認できました。
mysql> SELECT TABLE_NAME, KEY_NAME, COLUMN_NAME, IS_GLOBAL FROM INFORMATION_SCHEMA.TIDB_INDEXES WHERE TABLE_NAME = 't';
+------------+-----------------+-------------+-----------+
| TABLE_NAME | KEY_NAME        | COLUMN_NAME | IS_GLOBAL |
+------------+-----------------+-------------+-----------+
| t          | PRIMARY         | id          |         0 |
| t          | PRIMARY         | order_date  |         0 |
| t          | idx_order_date  | order_date  |         0 |
| t          | idx_customer_id | customer_id |         1 |
+------------+-----------------+-------------+-----------+
4 rows in set (0.01 sec)
なお、パーティションしていないテーブルで GLOBAL 指定するとエラーになりました。
mysql> CREATE TABLE tx (
    ->                  id BIGINT NOT NULL AUTO_INCREMENT,
    ->                  customer_id BIGINT NOT NULL,
    ->                  order_date DATE NOT NULL,
    ->                  PRIMARY KEY (id),
    ->                  KEY idx_customer_id (customer_id) GLOBAL,
    ->                  KEY idx_order_date (order_date))
    -> ;
ERROR 8200 (HY000): Unsupported Global Index on non-partitioned table
パフォーマンステスト用のデータ
パーティションキーは order_date の年です。 パーティション化なし と パーティション数 2, 4, 8, 16 の合計 5パターンのテーブルで計測しました。
-- 16パーティションの定義
mysql> SHOW CREATE TABLE tg16 \G
*************************** 1. row ***************************
       Table: tg16
Create Table: CREATE TABLE `tg16` (
  `id` bigint NOT NULL AUTO_INCREMENT,
  `customer_id` bigint NOT NULL,
  `order_date` date NOT NULL,
  PRIMARY KEY (`id`,`order_date`) /*T![clustered_index] CLUSTERED */,
  KEY `idx_customer_id` (`customer_id`) /*T![global_index] GLOBAL */,
  KEY `idx_order_date` (`order_date`) /*T![global_index] GLOBAL */
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_bin AUTO_INCREMENT=10032572
PARTITION BY RANGE (YEAR(`order_date`))
(PARTITION `p2001` VALUES LESS THAN (2001),
 PARTITION `p2002` VALUES LESS THAN (2002),
 PARTITION `p2003` VALUES LESS THAN (2003),
 PARTITION `p2004` VALUES LESS THAN (2004),
 PARTITION `p2005` VALUES LESS THAN (2005),
 PARTITION `p2006` VALUES LESS THAN (2006),
 PARTITION `p2007` VALUES LESS THAN (2007),
 PARTITION `p2008` VALUES LESS THAN (2008),
 PARTITION `p2009` VALUES LESS THAN (2009),
 PARTITION `p2010` VALUES LESS THAN (2010),
 PARTITION `p2011` VALUES LESS THAN (2011),
 PARTITION `p2012` VALUES LESS THAN (2012),
 PARTITION `p2013` VALUES LESS THAN (2013),
 PARTITION `p2014` VALUES LESS THAN (2014),
 PARTITION `p2015` VALUES LESS THAN (2015),
 PARTITION `p2016` VALUES LESS THAN (2016))
1 row in set (0.01 sec)
mysql> select count(*), year(order_date) from tp0 group by year(order_date) ORDER BY year(order_date);
+----------+------------------+
| count(*) | year(order_date) |
+----------+------------------+
|   625000 |             2000 |
|   625000 |             2001 |
|   625000 |             2002 |
|   625000 |             2003 |
|   625000 |             2004 |
|   625000 |             2005 |
|   625000 |             2006 |
|   625000 |             2007 |
|   625000 |             2008 |
|   625000 |             2009 |
|   625000 |             2010 |
|   625000 |             2011 |
|   625000 |             2012 |
|   625000 |             2013 |
|   625000 |             2014 |
|   625000 |             2015 |
+----------+------------------+
16 rows in set (0.00 sec)
- レコード数は 1年あたり、625000 行、合計 1000万行。
- 各パーティションに含まれるレコード数のばらつきによる影響が出ないよう、各パーティションのレコード数は均等になるようにパーティションの区切りを調整。
- パーティション数 が 2 であれば、1パーティションあたりは 500万行、パーティション数 が 16 であれば、1パーティションあたり 62.5万行。
「パーティションプルーニングを効かせるには、ANALYZE せよ」とマニュアルにあったので、事前に ANALYZEしてからベンチマークを実行しています。
ローカル環境(PC1台)に tiup playground コマンドで TiDB x 1, TiKV x 3 をデプロイして検証しました。
最初は TiDB Cloud を使っていたのですが、安定した結果を得ることが出来ず、ローカル環境に落ち着きました。本当は分散DBなので複数台のマシンを使って確認するほうが良いんでしょうけど。
パーティションキーを含まない検索:グローバルインデックスにより性能が改善
パーティションキー order_date を含まないクエリの性能を見てみましょう。 クエリは customer_id = 1000 のレコードを1行 SELECTするシンプルなものです。
mysql> SELECT * FROM tg16 WHERE customer_id = 1000;
+------+-------------+------------+
| id   | customer_id | order_date |
+------+-------------+------------+
| 1000 |        1000 | 2000-09-06 |
+------+-------------+------------+
1 row in set (0.00 sec)
このクエリではインデックスのみが使われます(カバーリングインデックスになってる)
mysql> EXPLAIN SELECT * FROM tp16 WHERE customer_id = 1000 \G
*************************** 1. row ***************************
           id: IndexReader_6
      estRows: 1.00
         task: root
access object: partition:all
operator info: index:IndexRangeScan_5
*************************** 2. row ***************************
           id: └─IndexRangeScan_5
      estRows: 1.00
         task: cop[tikv]
access object: table:tp16, index:idx_customer_id(customer_id)
operator info: range:[1000,1000], keep order:false
2 rows in set (0.00 sec)
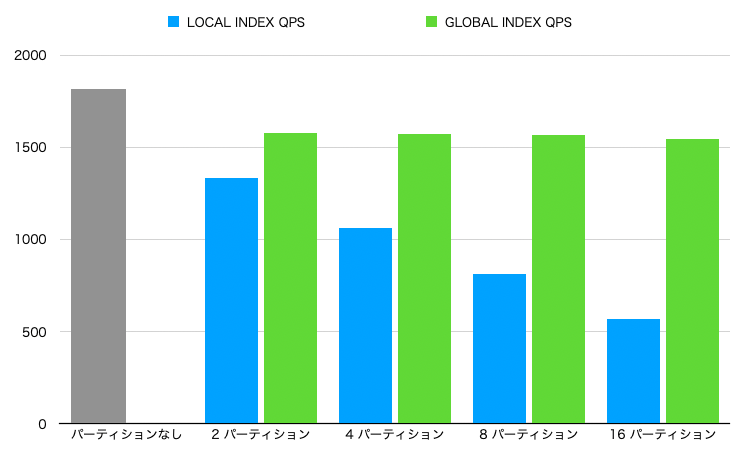
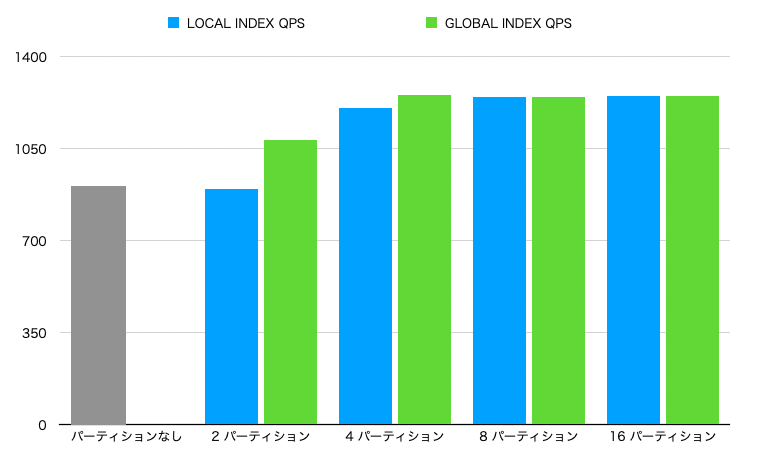
- ローカルインデックス(青グラフ)では、パーティション数を増やせば増やすほど、性能が低下しました。
パーティションキーを含まない検索xローカルインデックスでは、複数のインデックスをスキャンする必要があるため、パーティションすればするほど遅くなったと考えられます。これは想定通りの結果です。
- グローバルインデックス(緑グラフ)では、パーティションを増やしても性能劣化しなくなっています。
- グローバルインデックスはインデックスが分割されないため、パーティション数によらず、一定の性能を維持できたと考えられます。これも想定通りの結果です。
パーティションなし>グローバルインデックスになっているのは、よくわかりません。この2つのインデックスに違いはないと思ってたのですが。。。パーティション化自体に何かオーバーヘッドがあるんでしょうか。
パーティションキーを含む検索
mysql> SELECT COUNT(*) FROM tg16 WHERE order_date = "2011-01-01";
+----------+
| COUNT(*) |
+----------+
|     2500 |
+----------+
1 row in set (0.00 sec)
このクエリはパーティションプルーニングが効き、1つのパーティションにしかアクセスしません。
mysql> EXPLAIN SELECT COUNT(*) FROM tg16 WHERE order_date = "2011-01-01" \G
*************************** 1. row ***************************
           id: HashAgg_14
      estRows: 1.00
         task: root
access object:
operator info: funcs:count(Column#6)->Column#4
*************************** 2. row ***************************
           id: └─IndexReader_15
      estRows: 1.00
         task: root
access object: partition:p2012
operator info: index:HashAgg_6
*************************** 3. row ***************************
           id:   └─HashAgg_6
      estRows: 1.00
         task: cop[tikv]
access object:
operator info: funcs:count(1)->Column#6
*************************** 4. row ***************************
           id:     └─Selection_13
      estRows: 2494.22
         task: cop[tikv]
access object:
operator info: in(_tidb_tid, 266)
*************************** 5. row ***************************
           id:       └─IndexRangeScan_11
      estRows: 2494.22
         task: cop[tikv]
access object: table:tg16, index:idx_order_date(order_date)
operator info: range:[2011-01-01,2011-01-01], keep order:false
5 rows in set (0.00 sec)
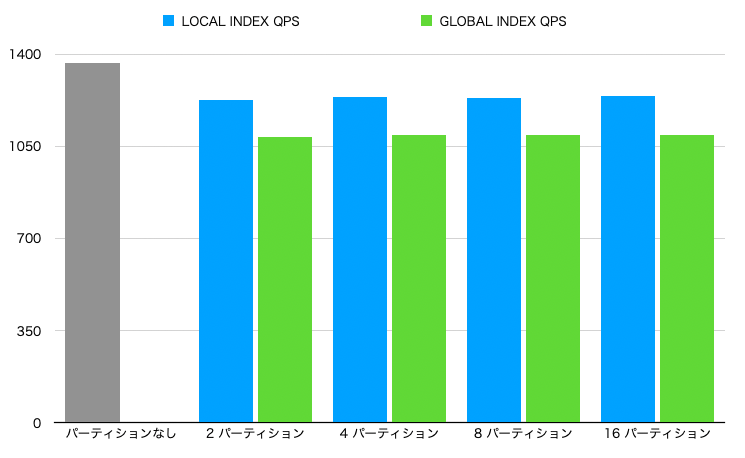
- ローカル、グローバルインデックスともに、パーティション数に限らず性能は一定でした。
- ローカルインデックス のほうが グローバルインデックス より優れたスコアでした。
- インデックスサイズが小さいローカルインデックスのほうが有利だったんでしょうか。しかし、そうすると、上記のパーティション数を増やしてもスコアが改善しなかったことと、矛盾しそうです。
- こちらも
パーティションなしが一番、良いスコアでした。- ローカルインデックスが一番良いと想定していたのですが、やはり、パーティション化自体に何かオーバーヘッドがあるのかもしれません。
フルテーブルスキャン
ヒント句を追加して、フルテーブルスキャンを選択させた場合です。
mysql> SELECT COUNT(*) FROM tg16 IGNORE INDEX (idx_order_date, idx_customer_id) WHERE order_date = "2011-01-01";
+----------+
| COUNT(*) |
+----------+
|     2500 |
+----------+
1 row in set (0.56 sec)
パーティションプルーニングによって、このクエリは1つのパーティションのみをスキャンします。 パーティション数が増えるほど性能が上がる想定です。
mysql> EXPLAIN SELECT COUNT(*) FROM tg16 IGNORE INDEX (idx_order_date, idx_customer_id) WHERE order_date = "2011-01-01" \G
*************************** 1. row ***************************
           id: HashAgg_13
      estRows: 1.00
         task: root
access object:
operator info: funcs:count(Column#5)->Column#4
*************************** 2. row ***************************
           id: └─TableReader_14
      estRows: 1.00
         task: root
access object: partition:p2012
operator info: data:HashAgg_6
*************************** 3. row ***************************
           id:   └─HashAgg_6
      estRows: 1.00
         task: cop[tikv]
access object:
operator info: funcs:count(1)->Column#5
*************************** 4. row ***************************
           id:     └─Selection_12
      estRows: 2494.22
         task: cop[tikv]
access object:
operator info: eq(test2.tg16.order_date, 2011-01-01 00:00:00.000000)
*************************** 5. row ***************************
           id:       └─TableFullScan_11
      estRows: 10000000.00
         task: cop[tikv]
access object: table:tg16
operator info: keep order:false
5 rows in set (0.01 sec)
- パーティション数が増えるにしたがって、性能が上がっています。
- ローカルインデックスとグローバルインデックスでスコアに差がでました。
- インデックスは使ってないので、同じスコアが出ると予想してたのですが。。。
まとめ
- グローバルインデックスの利用により、パーティションキーを含まない検索の性能が、期待通り改善することが確認できました 。
- 一部で想定外の結果もありました。データ量が十分でなかったのかもしれません 。時間があれば深掘りしてみたいと思います。
- TiFlash とパーティションの組み合わせも確認してみたいところです。
明日は meijik さんです!
ProxySQL を使った接続で KILL するのはややこしい
MySQL の KILL コマンドのおさらい
MySQL の KILL コマンドには 2種類あります。
KILL <CONNECTION_ID>またはKILL CONNECTION <CONNECTION_ID>- ターゲットの接続で実行中のクエリがあれば終了し、接続も切断します。
KILL QUERY <CONNECTION_ID>- ターゲットの接続で実行中のクエリを終了します。接続は維持します。
ProxySQL経由でのKILL - IDが食い違う問題
ProxySQL を経由した状態で KILL CONNECTION をやってみます。
ID 535 の SELECT SLEEP(100), user FROM mysql.user を KILL しましたが、クエリは実行されたままです。
mysql> SHOW PROCESSLIST;
+-----+-----------------+<snip>+-----------------------------------------+
| Id  | User            |<snip>| Info                                    |
+-----+-----------------+<snip>+-----------------------------------------+
|   6 | system user     |<snip>| NULL                                    |
|   7 | event_scheduler |<snip>| NULL                                    |
|  10 | system user     |<snip>| NULL                                    |
|  11 | system user     |<snip>| NULL                                    |
|  12 | system user     |<snip>| NULL                                    |
|  13 | system user     |<snip>| NULL                                    |
| 517 | root            |<snip>| NULL                                    |
| 526 | root            |<snip>| SHOW PROCESSLIST                        |
| 535 | root            |<snip>| SELECT SLEEP(100), user FROM mysql.user |
+-----+-----------------+<snip>+-----------------------------------------+
9 rows in set, 1 warning (0.00 sec)

mysql> KILL CONNECTION 535;
Query OK, 0 rows affected (0.00 sec)

mysql> SHOW PROCESSLIST;
+-----+-----------------+<snip>+-----------------------------------------+
| Id  | User            |<snip>| Info                                    |
+-----+-----------------+<snip>+-----------------------------------------+
|   6 | system user     |<snip>| NULL                                    |
|   7 | event_scheduler |<snip>| NULL                                    |
|  10 | system user     |<snip>| NULL                                    |
|  11 | system user     |<snip>| NULL                                    |
|  12 | system user     |<snip>| NULL                                    |
|  13 | system user     |<snip>| NULL                                    |
| 517 | root            |<snip>| NULL                                    |
| 526 | root            |<snip>| SHOW PROCESSLIST                        |
| 535 | root            |<snip>| SELECT SLEEP(100), user FROM mysql.user |
+-----+-----------------+<snip>+-----------------------------------------+
9 rows in set, 1 warning (0.00 sec)
前回のエントリーで、ProxySQL には独自の Connection ID があることを説明しました。 ProxySQL経由の接続を ProxySQL経由の接続を使って KILLするには、ProxySQLが管理している独自のConnection IDを使う必要があります。
ProxySQLで管理されているセッションの Connection Id を確認するには、ProxySQLの管理者用インターフェースに接続して、SHOW PROCESSLIST を実行します。
(SHOW PROCESSLIST コマンドを使う点は MySQL と同じですが、出力される項目が MySQL と少し違いますね)
$ mysql -h127.0.0.1 -P6032 -uadmin -padmin
mysql> SHOW PROCESSLIST;
+-----------+<snip>+---------+-----------------------------------------+
| SessionID |<snip>| time_ms | info                                    |
+-----------+<snip>+---------+-----------------------------------------+
| 2         |<snip>| 30030   | NULL                                    |
| 11        |<snip>| 0       | SELECT SLEEP(100), user FROM mysql.user |
+-----------+<snip>+---------+-----------------------------------------+
2 rows in set (0.00 sec)
ProxySQL の Connection ID (Session ID) 11 を指定してKILLすることで、MySQLの Id 713 を KILL 出来ました。
mysql> SHOW PROCESSLIST;
+-----+-----------------+<snip>+-----------------------------------------+
| Id  | User            |<snip>| Info                                    |
+-----+-----------------+<snip>+-----------------------------------------+
|   6 | system user     |<snip>| NULL                                    |
|   7 | event_scheduler |<snip>| NULL                                    |
|  10 | system user     |<snip>| NULL                                    |
|  11 | system user     |<snip>| NULL                                    |
|  12 | system user     |<snip>| NULL                                    |
|  13 | system user     |<snip>| NULL                                    |
| 659 | root            |<snip>| NULL                                    |
| 692 | root            |<snip>| SHOW PROCESSLIST                        |
| 713 | root            |<snip>| SELECT SLEEP(100), user FROM mysql.user |
+-----+-----------------+<snip>+-----------------------------------------+
9 rows in set, 1 warning (0.00 sec)

mysql> KILL 11;
Query OK, 0 rows affected (0.00 sec)

-- 713 がいなくなった
mysql> SHOW PROCESSLIST;
+-----+-----------------+<snip>+------------------+
| Id  | User            |<snip>| Info             |
+-----+-----------------+<snip>+------------------+
|   6 | system user     |<snip>| NULL             |
|   7 | event_scheduler |<snip>| NULL             |
|  10 | system user     |<snip>| NULL             |
|  11 | system user     |<snip>| NULL             |
|  12 | system user     |<snip>| NULL             |
|  13 | system user     |<snip>| NULL             |
| 659 | root            |<snip>| NULL             |
| 692 | root            |<snip>| SHOW PROCESSLIST |
+-----+-----------------+<snip>+------------------+
8 rows in set, 1 warning (0.00 sec)
なお、KILL QUERY も同様に、ProxySQL の Connection Id を指定する必要があります。
ProxySQL を複数利用している場合の注意点
Connection ID (Session ID) は、ProxySQLサーバーごとに管理されています。ある接続をKILLしたいときは、その接続を実際に処理しているProxySQLインスタンスに接続してKILLコマンドを実行しなければなりません。 複数のProxySQLインスタンスをロードバランサーの下で運用している場合、接続した先のProxySQLが該当の接続を担当している ProxySQL とは異なる ProxySQLインスタンスである可能性があります。
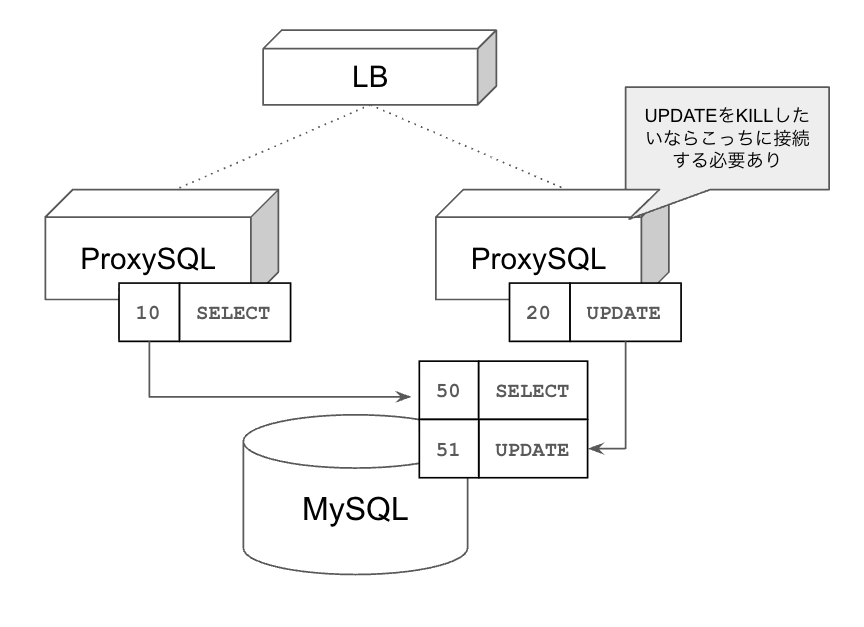
KILLする際は、ロードバランサ等を介さずに、各ProxySQLの管理者インタフェースに直接接続して KILL コマンドを実行するのが良いでしょう。 しかし、そうするには、どのProxySQLが目的の接続を処理しているのかを特定する必要があり、ProxySQLを介した、KILLのオペレーションは どうやっても煩雑になりそうです。
💡管理者インターフェイスでも KILL コマンドを使うことができます。ただし、管理者インタフェースでは KILL CONNECTION と CONNECTION を省略せずに書く必要がある。
mysql> KILL 15;
ERROR 1045 (28000): ProxySQL Admin Error: near "KILL": syntax error

mysql> KILL CONNECTION 15;
Query OK, 0 rows affected (0.00 sec)
まとめ
- ProxySQLを介して、KILLするとややこしいので、Backend の MySQLに直接接続して KILLするのが一番簡単で確実!
MySQL パーティションによる性能の変化を計測する
このエントリーは MySQL - Qiita Advent Calendar 2025 - Qiita の 13日目 のエントリーです。 昨日は、@discus_hamburg さんの 帰ってきた! 標準はあるにはあるが癖の多いSQL #20 - Table Value Constructer (TVC) でした。
以下のエントリーで、MySQL でパーティション化によって性能が向上するケース、劣化するケースを考察しました。 今回は、ベンチマークを行い、想定どおりの動きになっているか確かめてみます。
テストデータ
パーティションキーは order_date の年です。
パーティション化なし と パーティション数 2, 4, 8, 16 の合計 5パターンのテーブルで計測しました。
-- パーティション数2
mysql> SHOW CREATE TABLE t2 \G
*************************** 1. row ***************************
       Table: t2
Create Table: CREATE TABLE `t2` (
  `id` bigint NOT NULL AUTO_INCREMENT,
  `customer_id` bigint NOT NULL,
  `order_date` date NOT NULL,
  PRIMARY KEY (`id`,`order_date`),
  KEY `idx_customer_id` (`customer_id`),
  KEY `idx_order_date` (`order_date`)
) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci
/*!50100 PARTITION BY RANGE (year(`order_date`))
(PARTITION p2008 VALUES LESS THAN (2008) ENGINE = InnoDB,
 PARTITION p2016 VALUES LESS THAN (2016) ENGINE = InnoDB) */
1 row in set (0.00 sec)

-- パーティション数16
mysql> SHOW CREATE TABLE t16 \G
*************************** 1. row ***************************
       Table: t16
Create Table: CREATE TABLE `t16` (
  `id` bigint NOT NULL AUTO_INCREMENT,
  `customer_id` bigint NOT NULL,
  `order_date` date NOT NULL,
  PRIMARY KEY (`id`,`order_date`),
  KEY `idx_customer_id` (`customer_id`),
  KEY `idx_order_date` (`order_date`)
) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci
/*!50100 PARTITION BY RANGE (year(`order_date`))
(PARTITION p2001 VALUES LESS THAN (2001) ENGINE = InnoDB,
 PARTITION p2002 VALUES LESS THAN (2002) ENGINE = InnoDB,
 PARTITION p2003 VALUES LESS THAN (2003) ENGINE = InnoDB,
 PARTITION p2004 VALUES LESS THAN (2004) ENGINE = InnoDB,
 PARTITION p2005 VALUES LESS THAN (2005) ENGINE = InnoDB,
 PARTITION p2006 VALUES LESS THAN (2006) ENGINE = InnoDB,
 PARTITION p2007 VALUES LESS THAN (2007) ENGINE = InnoDB,
 PARTITION p2008 VALUES LESS THAN (2008) ENGINE = InnoDB,
 PARTITION p2009 VALUES LESS THAN (2009) ENGINE = InnoDB,
 PARTITION p2010 VALUES LESS THAN (2010) ENGINE = InnoDB,
 PARTITION p2011 VALUES LESS THAN (2011) ENGINE = InnoDB,
 PARTITION p2012 VALUES LESS THAN (2012) ENGINE = InnoDB,
 PARTITION p2013 VALUES LESS THAN (2013) ENGINE = InnoDB,
 PARTITION p2014 VALUES LESS THAN (2014) ENGINE = InnoDB,
 PARTITION p2015 VALUES LESS THAN (2015) ENGINE = InnoDB,
 PARTITION p2016 VALUES LESS THAN (2016) ENGINE = InnoDB) */
1 row in set (0.00 sec)
レコード数は 1年あたり、62500 行、合計 100万行。 各パーティションに含まれるレコード数のばらつきによる影響が出ないよう、各パーティションのレコード数は均等になるようにパーティションの区切りを調整しています。 パーティション数 が 2 であれば、1パーティションあたりは 50万行、パーティション数 が 16 であれば、1パーティションあたり 62500行です。
mysql> select count(*), year(order_date) from t0 group by year(order_date);
+----------+------------------+
| count(*) | year(order_date) |
+----------+------------------+
|    62500 |             2000 |
|    62500 |             2001 |
|    62500 |             2002 |
|    62500 |             2003 |
|    62500 |             2004 |
|    62500 |             2005 |
|    62500 |             2006 |
|    62500 |             2007 |
|    62500 |             2008 |
|    62500 |             2009 |
|    62500 |             2010 |
|    62500 |             2011 |
|    62500 |             2012 |
|    62500 |             2013 |
|    62500 |             2014 |
|    62500 |             2015 |
+----------+------------------+
16 rows in set (0.61 sec)
MySQL はバージョン 8.0.44 を利用しました。
パーティションキーを含まない検索:性能が低下
パーティションキー order_date を含まないクエリの性能を見てみましょう。
クエリは customer_id = 1000 のレコードをSELECTするシンプルなものです。
mysql> SELECT * FROM t2 WHERE customer_id = 1000;
+------+-------------+------------+
| id   | customer_id | order_date |
+------+-------------+------------+
| 1000 |        1000 | 2000-09-06 |
+------+-------------+------------+
1 row in set (0.00 sec)
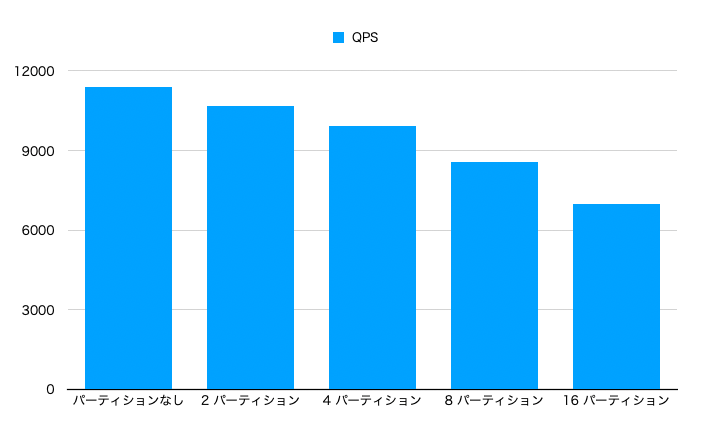
パーティションしていない場合がもっとも速く、またパーティション数を増やすにつれて、性能が劣化していきます。 前回の記事に書いたとおり、パーティション化により複数のインデックスをスキャンする必要があるため、パーティションすればするほど遅くなったと考えられます。
実行計画からも partitions: p2001,p2002,p2003,... とすべてのパーティションをスキャンしていることが読み取れます。
mysql> EXPLAIN SELECT * FROM t16 WHERE customer_id = 1000 \G
*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: t16
   partitions: p2001,p2002,p2003,p2004,p2005,p2006,p2007,p2008,p2009,p2010,p2011,p2012,p2013,p2014,p2015,p2016
         type: ref
possible_keys: idx_customer_id
          key: idx_customer_id
      key_len: 8
          ref: const
         rows: 1
     filtered: 100.00
        Extra: Using index
1 row in set, 1 warning (0.00 sec)
インデックスを使うパーティションキーを含んだ検索:変化なし
次は検索条件にパーティションキーを含む場合です。
このクエリはパーティションをまたがず、単一のパーティションのデータを取り出します。
order_date にはインデックスが追加してあり、このクエリはインデックスにより最適化されます。
SELECT COUNT(*) FROM t16 WHERE order_date BETWEEN "2011-01-01" AND "2011-12-31"
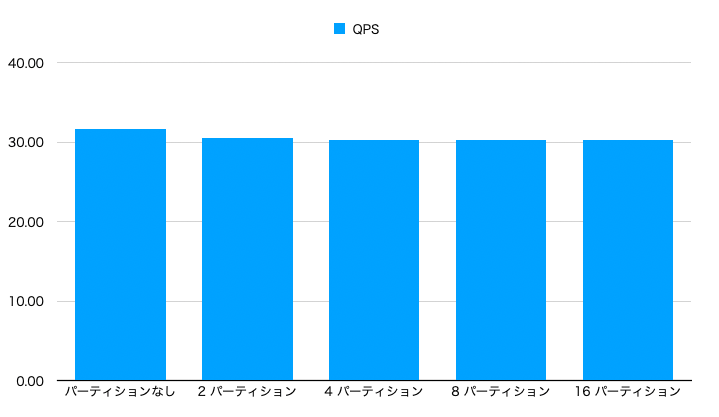
インデックスが効くようなクエリでは、パーティション有無による大きな差はありませんでした (パーティションしないほうが若干速い...)。
パーティション化によってインデックスも分割されているはずですが、インデックス(B-Tree) の検索コストは O(log n) なので、16分割程度では差がでないのでしょう。
実行計画ではパーティションプルーニングされていることが確認できます。
mysql> EXPLAIN SELECT COUNT(*) FROM t16 WHERE order_date BETWEEN "2011-01-01" AND "2011-12-31" \G
*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: t16
   partitions: p2012
         type: range
possible_keys: PRIMARY,idx_customer_id,idx_order_date
          key: idx_order_date
      key_len: 3
          ref: NULL
         rows: 31387
     filtered: 100.00
        Extra: Using where; Using index
1 row in set, 1 warning (0.00 sec)
ちなみに、より狭いレンジでのクエリでも同様の傾向でした。
SELECT COUNT(*) FROM t16 WHERE order_date = "2011-01-01"
テーブルフルスキャン:効果あり
パーティションキーを含んだ検索で、フルスキャンを利用する場合です。 先ほどのクエリにヒント句を追加して、フルスキャンを選択させました。
mysql> SELECT COUNT(*) FROM t16 IGNORE INDEX (idx_order_date, idx_customer_id) WHERE order_date BETWEEN "2011-01-01" AND "2011-12-31";
+----------+
| COUNT(*) |
+----------+
|    62500 |
+----------+
1 row in set (0.06 sec)
パーティション数を増やすと、レスポンスタイムが小さくなり、性能が向上しました。 パーティションプルーニングによる効果が確認できました。
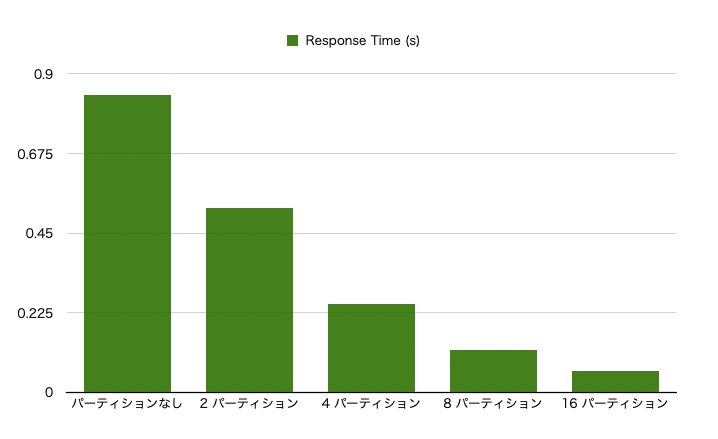
実行計画でも、パーティション化したテーブルでは rows の見積もりが小さくなっています。
-- パーティションなし
mysql> EXPLAIN SELECT COUNT(*) FROM t0 IGNORE INDEX (idx_order_date, idx_customer_id) WHERE order_date BETWEEN "2011-01-01" AND "2011-12-31" \G
*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: t0
   partitions: NULL
         type: ALL
possible_keys: NULL
          key: NULL
      key_len: NULL
          ref: NULL
         rows: 997878
     filtered: 11.11
        Extra: Using where
1 row in set, 1 warning (0.00 sec)

-- パーティションあり
mysql> EXPLAIN SELECT COUNT(*) FROM t16 IGNORE INDEX (idx_order_date, idx_customer_id) WHERE order_date BETWEEN "2011-01-01" AND "2011-12-31 " \G
*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: t16
   partitions: p2012
         type: index
possible_keys: PRIMARY
          key: PRIMARY
      key_len: 11
          ref: NULL
         rows: 62775
     filtered: 11.11
        Extra: Using where; Using index
1 row in set, 1 warning (0.00 sec)
まとめ
| 検索条件にパーティションキーを含むか | インデックスの利用 | パーティション化の効果 |
|---|---|---|
| 含まない | インデックスを利用 | 性能向上は見込めず、オーバーヘッドが増える。 |
| 含む | インデックスを利用 | インデックスが効率的なため、パーティションの恩恵はほとんどない。 |
| 含む | フルスキャン | パーティションプルーニングによる読み込みデータ量削減で性能が向上する。 |
明日は、zoosm3 さんです!
ProxySQL を使うと CONNECTION_ID() が MySQLと 異なる値を示す?
このエントリーは MySQL - Qiita Advent Calendar 2025 - Qiita の 10日目 のエントリーです。 昨日は @himura467 さんの 令和七年冬、DBD::mysql の quote メソッドを読む - ひむ日記 でした。
MySQL の Connection ID のおさらい
MySQLでは、クライアントから接続があるたびに、そのセッション(接続)を一意に識別するためのIDが割り当てられます。
Connection IDは、主に以下の方法で確認できます。
CONNECTION_ID()関数
現在のセッションのIDを取得します。
mysql> SELECT CONNECTION_ID();
+-----------------+
| CONNECTION_ID() |
+-----------------+
|             132 |
+-----------------+
1 row in set (0.00 sec)
mysqlコマンドのバナー
mysql コマンドで接続すると表示されるバナー中の Your MySQL connection id is 〜 でも確認できます。
$ mysql -h 127.0.0.1 -P 3306 -uroot
Welcome to the MySQL monitor.  Commands end with ; or \g.
Your MySQL connection id is 132
Server version: 8.0.44 MySQL Community Server - GPL
SHOW PROCESSLIST
Id 列で、他のセッションの Connection ID を確認することも出来ます。
mysql> SHOW PROCESSLIST;
+-----+-----------------+-----------------+<snip>-+------------------+
| Id  | User            | Host            |<snip> | Info             |
+-----+-----------------+-----------------+<snip>-+------------------+
|   6 | system user     |                 |<snip> | NULL             |
|   7 | event_scheduler | localhost       |<snip> | NULL             |
|  10 | system user     |                 |<snip> | NULL             |
|  11 | system user     |                 |<snip> | NULL             |
|  12 | system user     |                 |<snip> | NULL             |
|  13 | system user     |                 |<snip> | NULL             |
| 101 | root            | 127.0.0.1:43448 |<snip> | NULL             |
| 118 | root            | 127.0.0.1:43282 |<snip> | NULL             |
| 132 | root            | 127.0.0.1:60344 |<snip> | SHOW PROCESSLIST |
+-----+-----------------+-----------------+<snip>-+------------------+
9 rows in set, 1 warning (0.00 sec)
このConnection IDは、主にサーバー側での管理やトラブルシューティングに使用されます。
- 接続をKILLする
EXPLAIN FOR CONNECTION XXXで実行中のクエリの実行計画を確認する
ProxySQL経由でCONNECTION_ID()の挙動
ProxySQL を経由した場合、SELECT CONNECTION_ID() が 「ProxySQL が独自に生成したコネクションID」になってしまいます*1。
以下の例では、SELECT CONNECTION_ID() は 7 を返していますが、SHOW PROCESSLISTでMySQL側の状態を確認すると、実際のコネクションIDは 118 です。
mysql> SELECT CONNECTION_ID();
+-----------------+
| CONNECTION_ID() |
+-----------------+
|               7 |
+-----------------+
1 row in set (0.00 sec)

mysql> SHOW PROCESSLIST;
+-----+-----------------+-----------------+<snip>-+------------------+
| Id  | User            | Host            |<snip> | Info             |
+-----+-----------------+-----------------+<snip>-+------------------+
|   6 | system user     |                 |<snip> | NULL             |
|   7 | event_scheduler | localhost       |<snip> | NULL             |
|  10 | system user     |                 |<snip> | NULL             |
|  11 | system user     |                 |<snip> | NULL             |
|  12 | system user     |                 |<snip> | NULL             |
|  13 | system user     |                 |<snip> | NULL             |
| 101 | root            | 127.0.0.1:43448 |<snip> | NULL             |
| 118 | root            | 127.0.0.1:43282 |<snip> | SHOW PROCESSLIST |
| 132 | root            | 127.0.0.1:60344 |<snip> | NULL             |
+-----+-----------------+-----------------+<snip>-+------------------+
9 rows in set, 1 warning (0.00 sec)
なお、この挙動は ProxySQL の multiplexing を OFF にしていても起こります。
CONNECTION_ID() 関数の結果が置き換えられいる・・・わけではない
CONNECTION_ID() 関数が MySQL と異なる動きをしているように見えるのですが、よくよく調べてみると、違いました。
なんと、SQL が SELECT CONNECTION_ID() と完全一致したときのみ、 ProxySQL の ID を返すような挙動になっていました。
以下の例では「AS〜」を付けただけで、MySQLの Connection ID が取得できていることがわかります。
mysql> SELECT CONNECTION_ID();
+-----------------+
| CONNECTION_ID() |
+-----------------+
|               9 |
+-----------------+
1 row in set (0.00 sec)

mysql> SELECT CONNECTION_ID() AS cid;
+-----+
| cid |
+-----+
| 118 |
+-----+
1 row in set (0.00 sec)
CONNECTION_ID<スペース>() でも MySQL の Connection ID になります。
mysql> SELECT CONNECTION_ID ();
+------------------+
| CONNECTION_ID () |
+------------------+
|              118 |
+------------------+
1 row in set (0.00 sec)
もちろん、INSERT 文でも正しく MySQL の Connection ID になります。
mysql> INSERT INTO t VALUES(CONNECTION_ID());
Query OK, 1 row affected (0.01 sec)

mysql> SELECT * FROM t;
+------+
| a    |
+------+
|  118 |
+------+
1 row in set (0.00 sec)
SELECT CONNECTION_ID() だけであれば、アプリへの影響がなさそうで安心しました。しかし、謎な仕様...
明日は hmatsu47 さんです!
*1: ProxySQL 3.0.3 で確認しました
MySQL ではパーティションの出番があまりない
MySQLではパーティションの利用機会は少ないと感じています。Oracleではパーティションをよく利用していました。 「MySQLであまり活用されないのはこういう背景なんじゃないか」と思うことを列挙してみます。
パーティションが効くような用途で使われにくい
まず、MySQLではパーティションが効くような用途での利用が少ないです。 MySQLはOLTP を得意とするデータベースです。OLTP系のワークロードでは、インデックスによる最適化が選択されます。
OLAP系ワークロードでは、大量のレコードをスキャンすることが多く、フルスキャンを効率化する手段としてパーティションが活用されます。
MySQLのパーティション機能自体の制約
MySQLのパーティション機能自体が弱いと言わざるをえません。
主キー、ユニークキーにパーティションキーを含める必要がある
例えば、「日付」カラムでレンジパーティションを切るとしたら、「日付」カラムを主キーに追加しなければなりません。 パーティション化のために、制約を緩める必要が出てきてしまいます。性能と制約のトレードオフが発生する場合があります。
mysql> CREATE TABLE orders (
    ->     order_id INT NOT NULL AUTO_INCREMENT,
    ->     order_date DATE NOT NULL,
    ->     customer_id INT NOT NULL,
    ->     total_amount INT NOT NULL,
    ->     PRIMARY KEY(order_id)
    -> )
    -> PARTITION BY RANGE (YEAR(order_date)) (
    ->     PARTITION p2023 VALUES LESS THAN (2024),
    ->     PARTITION p2024 VALUES LESS THAN (2025),
    ->     PARTITION p2025 VALUES LESS THAN (2026),
    ->     PARTITION pmax VALUES LESS THAN MAXVALUE
    -> );
ERROR 1503 (HY000): A PRIMARY KEY must include all columns in the table's partitioning function (prefixed columns are not considered).
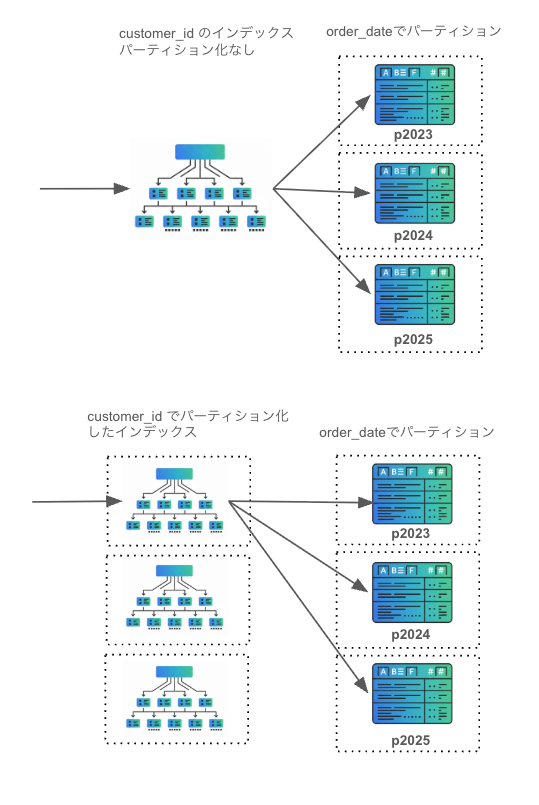
インデックスもパーティションされてしまう
MySQL (InnoDB) ではテーブルをパーティション化すると、セカンダリインデックスも、パーティションごとに作成されてしまいます(Oracleでいう ローカルパーティションインデックス)。 パーティションキー以外を含まない検索をする場合、パーティション化していない場合と比べてオーバーヘッドが増加し、性能が劣化する可能性があります。すべてのパーティションのインデックスをスキャンする必要があるためです。
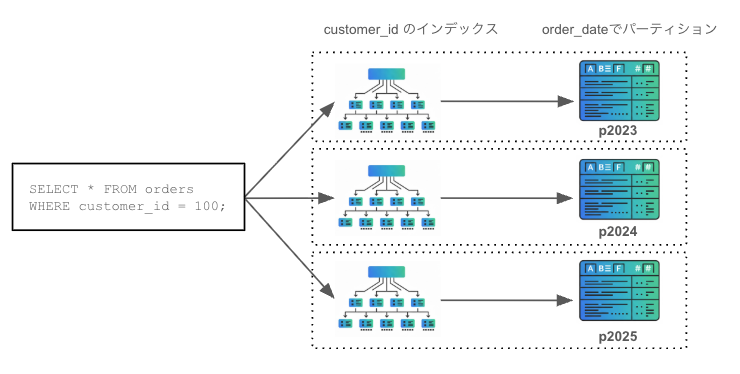
セカンダリインデックスを「パーティション化しない」もしくは「テーブルと異なるキーでパーティション化」することはMySQLではできません。
パラレル処理されない
パーティションを跨ぐクエリを実行しても、各パーティションの処理が並列で実行されるわけではありません。
MySQLでパーティションを使うとき
MySQL ではパフォーマンス改善というよりデータの削除を簡単にするために使われるケースが多いのではないでしょうか。
MySQLで大量のデータを通常のDELETE 文で消去しようとすると、以下のリスクがあります。
日付でパーティショニングしておけば、不要な過去データのパーティションをALTER TABLE ... DROP PARTITIONで削除できます (もしくは、EXCHANGE PARTITION で追い出す) 。
これはメタデータの変更のみで済み、データファイルが丸ごと削除されるため、非常に高速です。上記のようなリスクを回避できます。
また、DELETEと違い、データファイルごと削除されるため、物理的なディスク容量が即座に解放されるというメリットもあります。
Cloud SQL と AlloyDB for PostgreSQL のざっくりとした比較
機能面の違い
AWS でいうと、Cloud SQL が RDS PostgreSQL で AlloyDB が Aurora に相当する位置付け。
AlloyDB の特徴
- インテリジェントでスケーラブルなストレージ
- HTAPをサポートし、カラムナーエンジンを搭載
- AI / 機会学習をサポート
コストの比較
AlloyDB は 概ね、Cloud SQL Enterise Plus の 1.2倍 のコスト。3 year CUD でみても、同じ。 ただし、AlloyDB はレプリカやスタンバイ インスタンスを追加してもストレージコストがかからない。
| On Demand | vCPU / month | MEM / month | GB / month |
|---|---|---|---|
| Cloud SQL Enterprise (汎用/SSD) | $39.20 | $6.64 | $0.22 |
| Cloud SQL Enterprise Plus (N2/SSD) | $50.95 | $8.61 | $0.22 |
| AlloyDB for PostgreSQL (N2) | $61.74 | $10.47 | $0.38 |
| 3 year CUD | vCPU / month | MEM / month | GB / month |
|---|---|---|---|
| Cloud SQL Enterprise (汎用/SSD) | $18.81 | $3.18 | - |
| Cloud SQL Enterprise Plus (N2/SSD) | $24.46 | $4.13 | - |
| AlloyDB for PostgreSQL (N2) | $29.64 | $5.02 | - |
- 最小構成
| 構成 | |
|---|---|
| Cloud SQL Enterprise | db-f1-micro (1 vCPU, 628M MEM) |
| AlloyDB for PostgreSQL | 2vCPU - 8GMEM |
所管
基本的には AlloyDB を選んでおけば良さそう。
Cloud SQL - PostgreSQL を選ぶ場面としては、
- Vanilla の PostgreSQL であることが求められる場合
- 困ったら、AlloyDB に変えられるという選択肢が簡単に取れる場合
かな。
